
“Yapay Zekâ söyle bana memleket nire?
Mangarar mı, Kansoham mı, Sattere mi, Burona mı yoksa Smun Roçimat mı?”
Altı farklı yapay zekâya aynı soruyu sordum:
“Türkiye haritası üzerinde Kırşehir, Nevşehir, Aksaray ve Niğde illerinin sınırlarını gösteren bir harita çizer misin? Haritada bütün Türkiye bulunsun ama bu dört il farklı renklerde belirtilsin.”
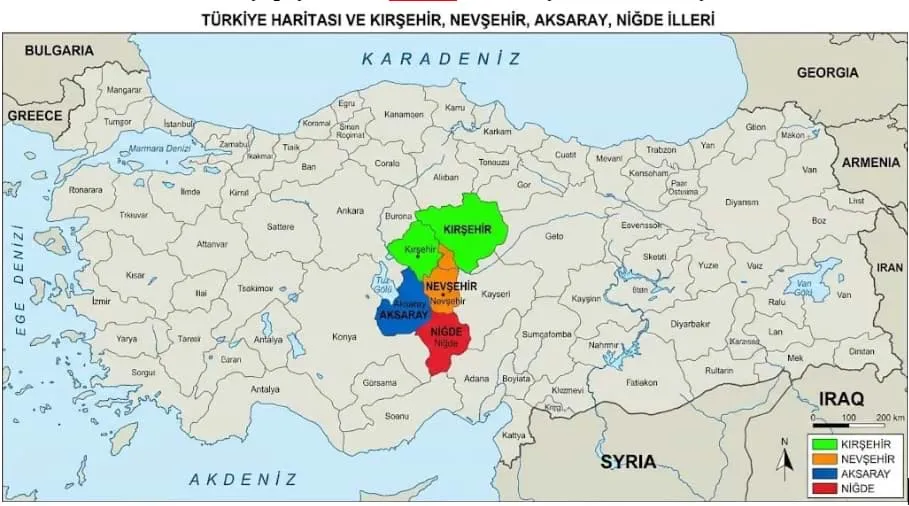
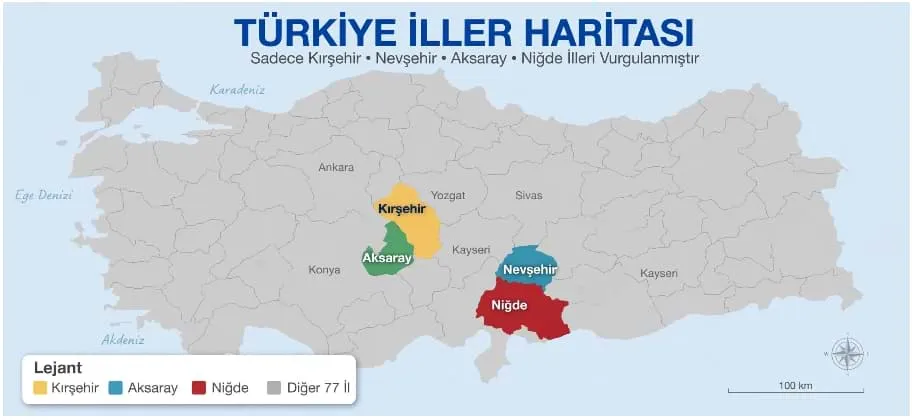
Sonuçta ortaya altı ayrı harita çıktı. Altısı da yanlış!
Bazılarında illerin yerleri değişmiş, bazılarında sınırlar birbirine karışmış. Birinde ise yapay zekâ yeni şehirler icat etmiş! Mangarar, Kansoham, Sattere, Burona, Tsakimo, Smun Roçimat ve daha onlarcası… Mesela bizim Bilecik olmuş Kirral.
Üstelik haritaların hepsi ilk bakışta oldukça düzgün ve inandırıcı görünüyor.
Peki sorun nerede? Soruyu yanlış mı sordum? Yapay zekâların eğitiminde mi eksiklik var? Yoksa kullandıkları veri tabanları mı yetersiz?
Bu soruları yapay zekâ konusunda çalışan birinci derece akrabama :) sordum.
Cevabı şöyle özetleyeyim:
“Yapay zekânın bilgiyi nasıl ürettiği önemli. Görüntü üreten yapay zekâ, Türkiye haritasını çizerken mutlaka gerçek coğrafi verilerden yararlanmıyor. Eğitiminde karşılaştığı çok sayıda görüntüden öğrendiği ilişkilerle yeni bir harita oluşturuyor. Türkiye’nin genel şeklini biliyor. İllerin yaklaşık konumlarını da biliyor olabilir. Ancak bu, il sınırlarını doğru çizebildiği anlamına gelmiyor.”
Aslında doğru haritayı üretmek için kullanılabilecek yöntem belli. Türkiye’nin 81 ilinin gerçek idari sınırlarını içeren coğrafi verilerden yararlanılabilir. İstenen dört il farklı renklerle gösterilebilir. Böylece sonuç da doğrulanabilir.
Ancak burada önemli bir ayrım varmış. Görüntü üreten yapay zekâ ile coğrafi verileri işleyerek harita hazırlayan yazılım aynı yöntemle çalışmıyormuş. Sorunun nasıl sorulduğu, kullanılan araç ve seçilen yöntem sonucu etkiliyormuş.
Peki kullanıcı bunların hepsini bilmek zorunda mı?
Fikir Coğrafyası’nda bir süredir “Veriokrasi” veya “Algoritmik Veri Devletleri” olarak adlandırdığım yapay zekâ çağında siyasetin ve dünyanın nereye gideceğini tartışıyorum. Devletin bilgi toplama, değerlendirme ve karar verme süreçlerinde algoritmaların giderek daha fazla rol üstlenmesi üzerinde duruyorum.
Yazı dizisinde sırada enerji meselesi vardı. Diziyi “Yapay Zekâ Çağında Eğitim” ve “Yapay Zekâ Çağında Tarihçilik: Belgeden Algoritmaya” başlıklı değerlendirmelerle tamamlamayı planlıyorum. O yazılar üzerinde çalışmayı sürdürüyorum. Ancak bugün yapay zekâyla yaptığım yazışmalar, eğitim ve tarihçilik yazılarına epey malzeme verdi. Enerji yazısından önce bu yazışmaları paylaşmak istedim.
Yapay zekânın çizdiği bu haritalar, bendeki endişeleri somutlaştırıyor.
Altı farklı yapay zekâ, dört ilin sınırlarını yanlış çizdiği hâlde son derece inandırıcı görüntüler üretebiliyor. Benzer sorunlarla tarihî belgelerde, istatistiklerde, bilimsel araştırmalarda ve arşiv kayıtlarında da karşılaşabiliyoruz. Daha on gün önce hakemliğime başvurulan bir makalenin kaynakçasında bana atıf yapılmıştı. Hiç duymadığım bir kitabevinden çıkan, hiç duymadığım ama benim yazdığım iddia edilen bir kitaba.
Yanlış bilgi, doğruymuş gibi sunulabiliyor. Üstelik oldukça profesyonel bir görünümle.
Yapay zekânın bilgi üretme kapasitesi her geçen gün artıyor. Fakat üretilen bilginin doğruluğu ve güvenilirliği meselesi hâlâ önümüzde duruyor.
Haritaların yanlış olduğunu net olarak görebiliyoruz. Peki ya bilmediklerimiz?
Yapay zekânın verdiği cevabın yanlış olduğunu anlayabilmek için doğru cevabı zaten bilmemiz gerekiyorsa yapay zekâ bilgimizi ne ölçüde artırıyor?
Elbette yapay zekâdan yararlanacağız. Ancak bilimsel araştırmalarda kaynak, yöntem ve doğrulama konusundaki hassasiyetimizi korumak zorundayız.
Algoritmaların kamu yönetiminde ve devletin karar mekanizmalarında daha fazla yer alacağı bir dünyada bu hassasiyetin önemi çok daha büyük.
Tek soru, altı harita...
Bir tatil sabahı bana bunları düşündürdü.
Yeni yorum ekle